1. 서론
제목이 자극적이긴 하지만 100만건 이상의 join을 걸지 않은 더미 데이터를 생성하여 DB 테이블에 입력하는 방법에 대해서 알아보겠습니다.
방법은 둘다 python을 이용해서 더미 데이터를 생성하지만 DB에 다이렉트로 붙어서 입력을 하느냐 csv파일을 만들어서 입력하느냐의 차이입니다.
데이터가 많아질 수록 csv파일 혹은 sql파일을 만들어서 입력하는 것이 빠르다는 것을 이론적으로 알고 있지만 실질적으로 시간이 얼마나 걸리는지 대강 적으로나마 알아보도록 하겠습니다.
사용할 DB는 MariaDB입니다.
2. 본론.
2.1. 사용 테이블 DDL
CREATE TABLE `tbl_testuser` (
  `userCode` int(10) unsigned NOT NULL AUTO_INCREMENT,
  `userName` varchar(100) NOT NULL COMMENT '유저 이름',
  `userEmail` varchar(200) NOT NULL COMMENT '회원 이메일',
  `userPhone` varchar(300) NOT NULL COMMENT '회원 핸드폰 번호',
  `userCity` varchar(100) NOT NULL COMMENT '시',
  `userState` varchar(100) NOT NULL COMMENT '회원 주',
  `userAddress` varchar(200) NOT NULL COMMENT '회원 주소',
  `regDate` varchar(20) NOT NULL COMMENT '회원 등록일',
  PRIMARY KEY (`userCode`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci;
테스트에 앞서 테스트 입력을 할 테이블은 다음과 같습니다.
2.2. DB에 직접 등록
첫번째 방법은 더미 데이터를 만드는 즉시 DB에 접속하여 INSERT 하는 방법입니다.
사용한 코드는 다음과 같습니다.
from faker import Faker
import mysql.connector
from datetime import datetime

# 현재 시간 가져오기
now = datetime.now()

print("carege_db 시작 시간 : ", now.strftime("%Y-%m-%d %H:%M:%S"))

# Faker 객체 생성
fake = Faker()

# MySQL 연결 설정
db = mysql.connector.connect(
    host="localhost",
    user="root",
    password="1234",
    database="testdb",
    charset="utf8mb4",
    collation="utf8mb4_general_ci"
)


cursor = db.cursor()

# 데이터 저장을 위한 리스트
data = []

# 100만 개의 무작위 데이터 생성
for _ in range(1000000):
    userName = fake.name()                          # 이름
    userEmail = fake.email()                        # 이메일
    userPhone = fake.phone_number()                 # 핸드폰 번호
    userCity = fake.city()                          # 시
    userState = fake.state()                        # 주
    userAddress = fake.address()                    # 상세 주소
    regDate = fake.date_this_decade()               # 날짜 YYYY-MM-DD

    cursor.execute("INSERT INTO tbl_testuser (userName, userEmail, userPhone, userCity, userState, userAddress, regDate) VALUES (%s, %s, %s, %s, %s, %s, %s)", (userName, userEmail, userPhone, userCity, userState, userAddress, regDate))


db.commit()
cursor.close()
db.close()


print("carege_db 종료 시간 : ", now.strftime("%Y-%m-%d %H:%M:%S"))
테스트 DB에 접속하여 DDL로 생성한 테이블로 100만건의 무작위 데이터를 생성합니다.
해당 건은 vsCode를 이용해 python을 실행시키므로 얼마나 시간이 걸리는지 대략적으로 측정해봅니다.
다음 소스에 print 문을 넣어 시작 시간과 종료 시간을 알 수 있도록 추가하였습니다.
2.2.1. DB 입력 소요 시간.

해당 코드를 실행 시켰을때 소요된 시간입니다.
15분 정도 소요가 됩니다.
2.2.2. DB 입력 데이터
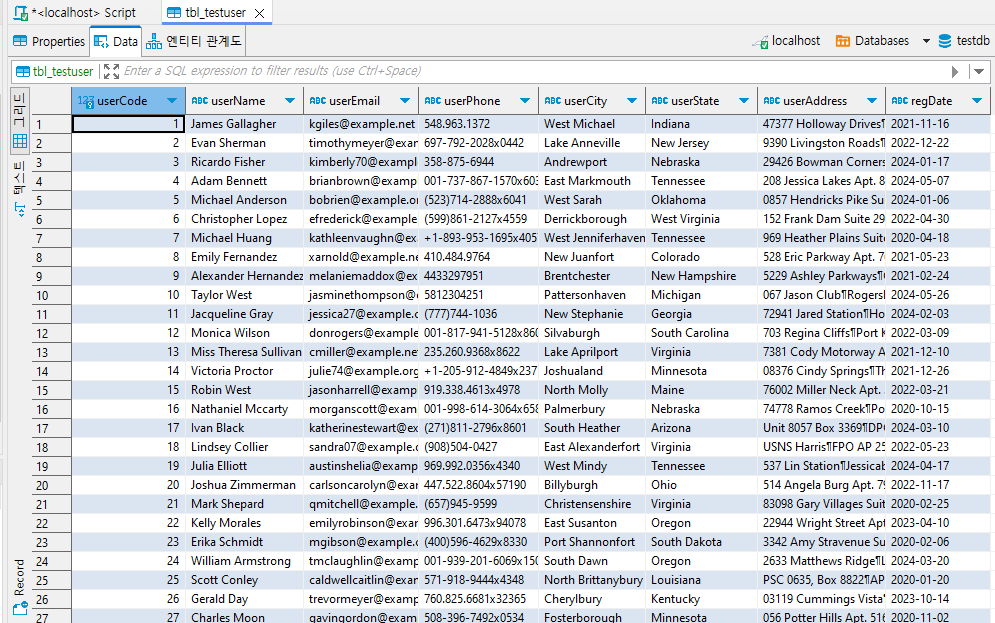
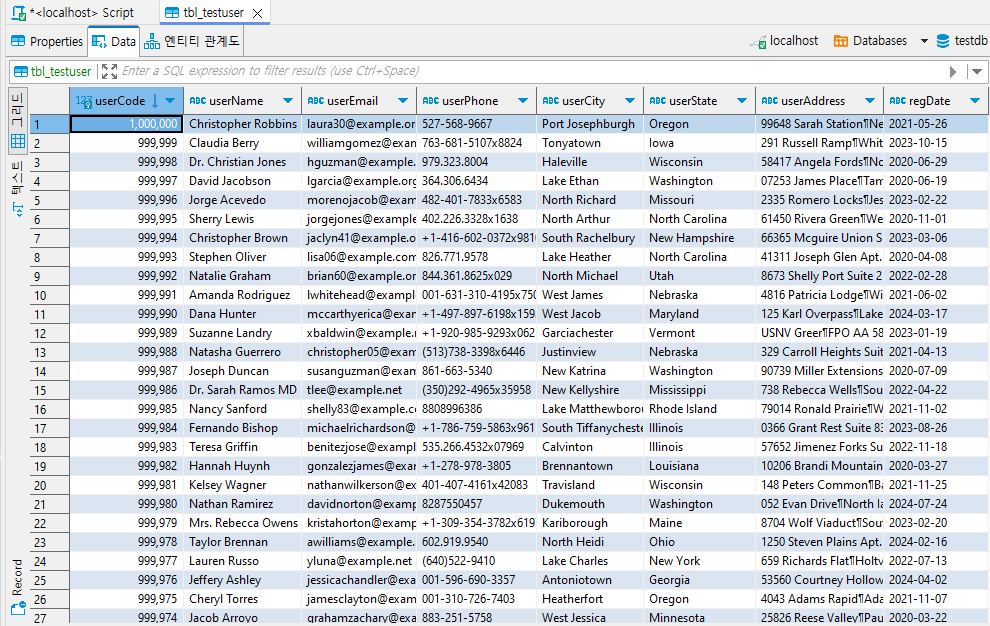
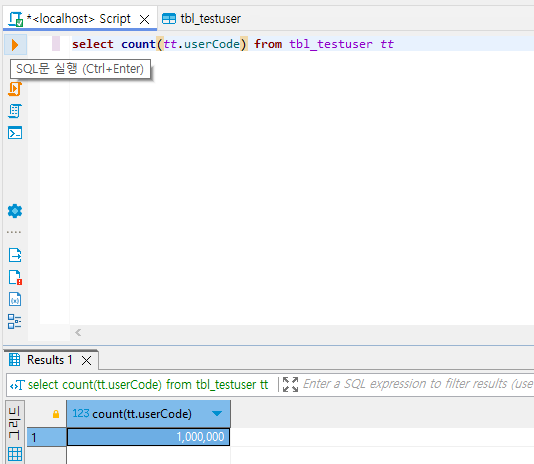
각각 입력된 데이터를 확인했을때 정확히 100만건이 입력된 것을 확인할 수 있습니다.
이제 csv파일을 생성해서 DB에 입력하는 방법을 사용해보겠습니다.
2.3. CSV 파일 생성
import pandas as pd
from faker import Faker
from datetime import datetime

# 현재 시간 가져오기
now = datetime.now()
print("carege_excel 시작 시간 : ", now.strftime("%Y-%m-%d %H:%M:%S"))

# Faker 객체 생성
fake = Faker()

# 데이터 저장을 위한 리스트
data = []

# 100만 개의 무작위 데이터 생성
for _ in range(1000000):
    userName = fake.name()                         # 이름
    userEmail = fake.email()                        # 이메일
    userPhone = fake.phone_number()                 # 핸드폰 번호
    userCity = fake.city()                          # 시
    userState = fake.state()                        # 주
    userAddress = fake.address()                    # 상세 주소
    regDate = fake.date_this_decade()               # 날짜 YYYY-MM-DD

    data.append([userName, userEmail, userPhone, userCity, userState, userAddress, regDate])

# pandas DataFrame으로 변환
df = pd.DataFrame(data, columns=['userName', 'userEmail', 'userPhone', 'userCity', 'userState', 'userAddress', 'regDate'])

# CSV 파일로 저장
df.to_csv('carete_excel.csv', index=False, encoding='utf-8-sig')

# 현재 시간 가져오기
now = datetime.now()
print("carege_excel 종료 시간 : ", now.strftime("%Y-%m-%d %H:%M:%S"))
동일하게 100건은 더미 데이터를 생성하여 csv 파일에 저장해봅니다.
다음은 csv 파일을 생성하는 코드입니다.
2.3.1. 데이터 생성 시간.

어...? 데이터 입력 까지는 아니지만 더미 데이터 생성에만 10분이나 걸렸습니다.
그렇다면 100만건의 데이터를 생성하는데 10분 데이터를 입력하는데 5분밖에 안걸렸나? 라고 생각할 수 있습니다.
하지만 csv파일을 DB 테이블에 적용하는 시간을 비교해봅시다.
2.3.2 CSV 파일 DB 적용
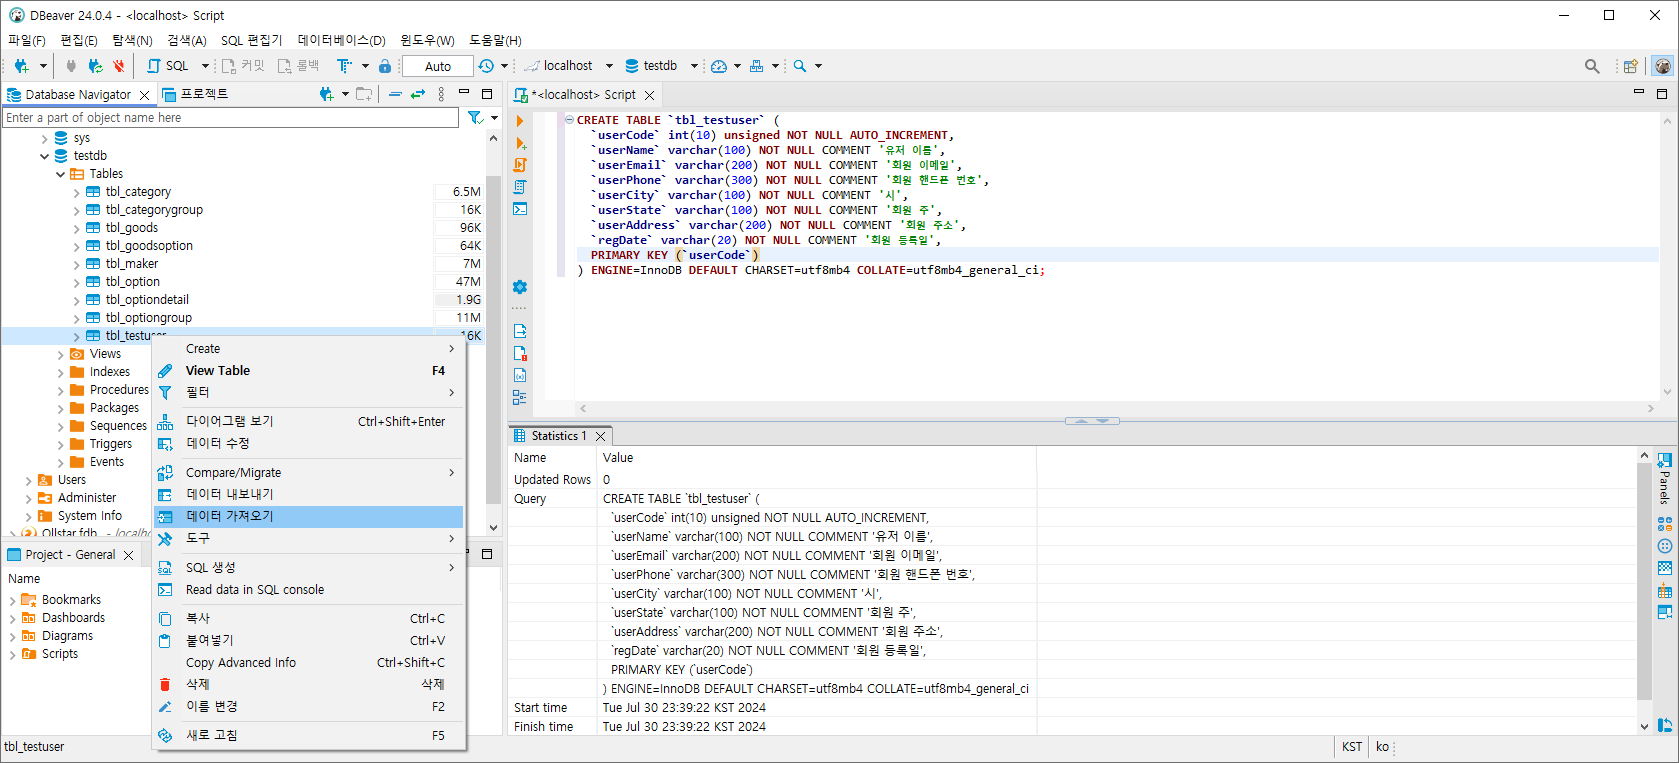
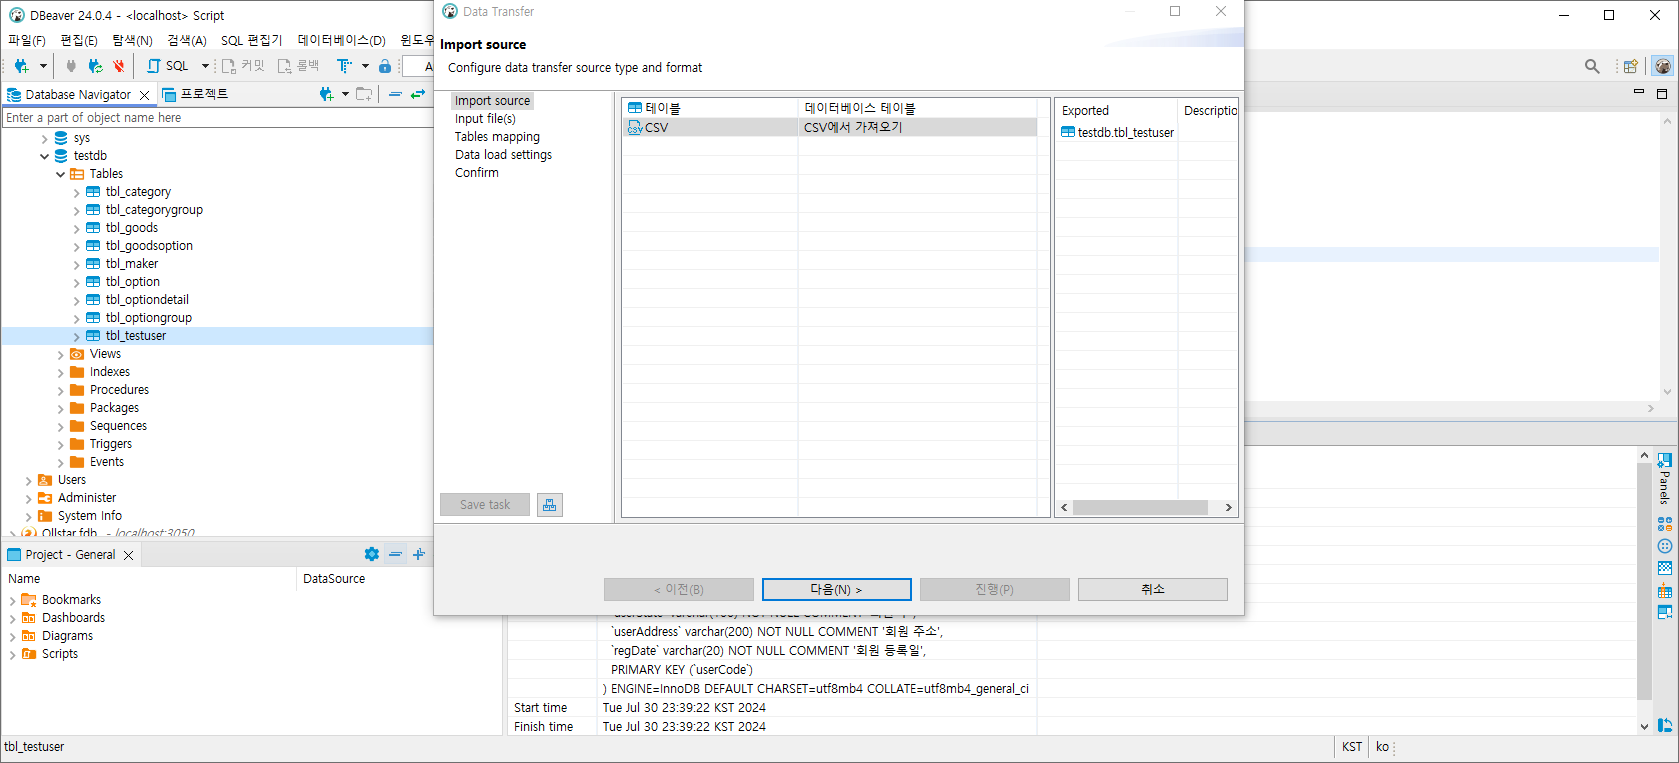
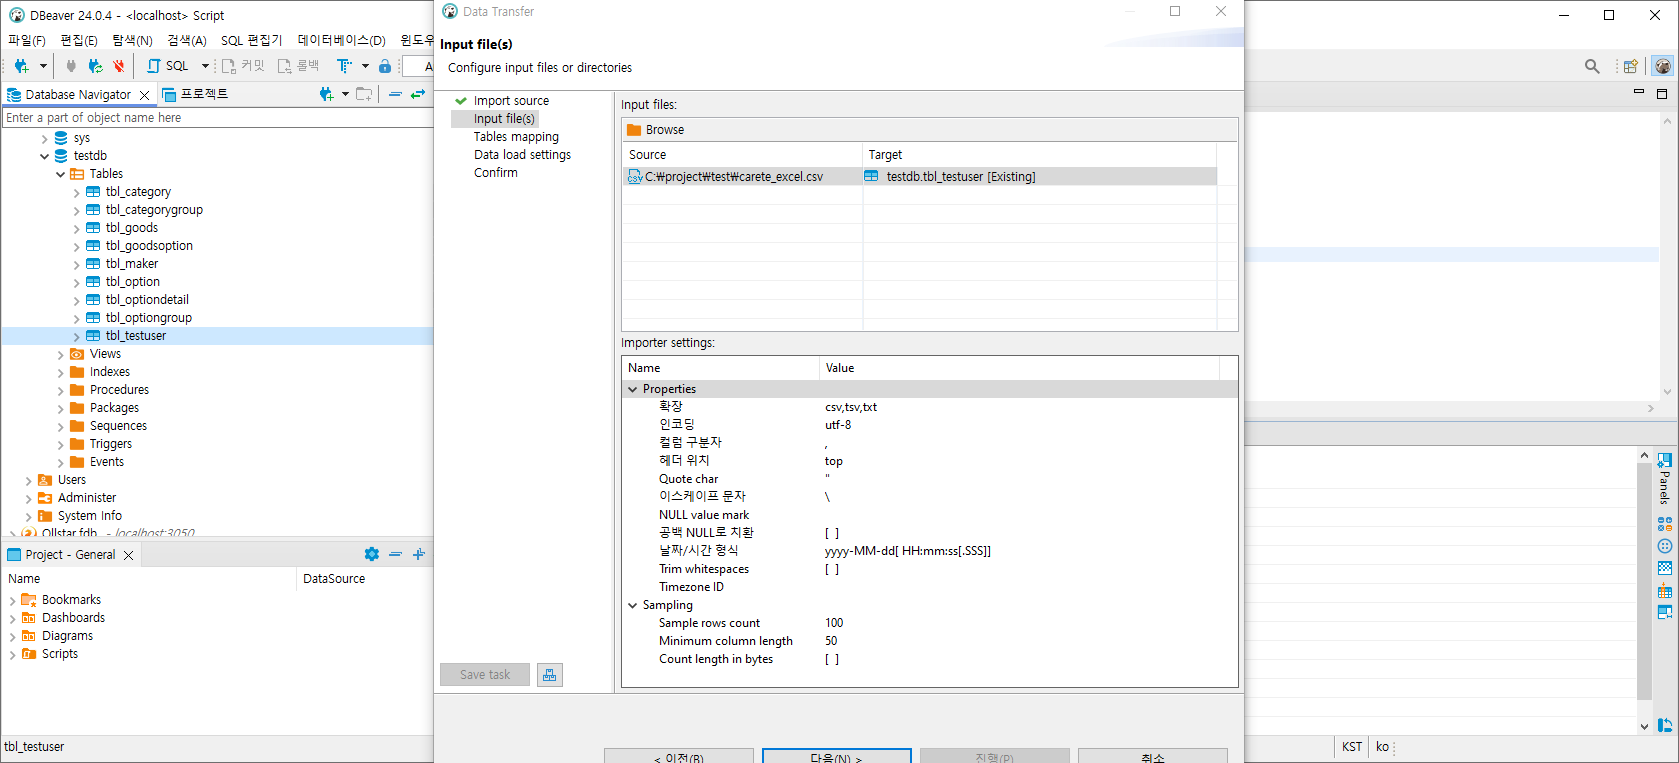
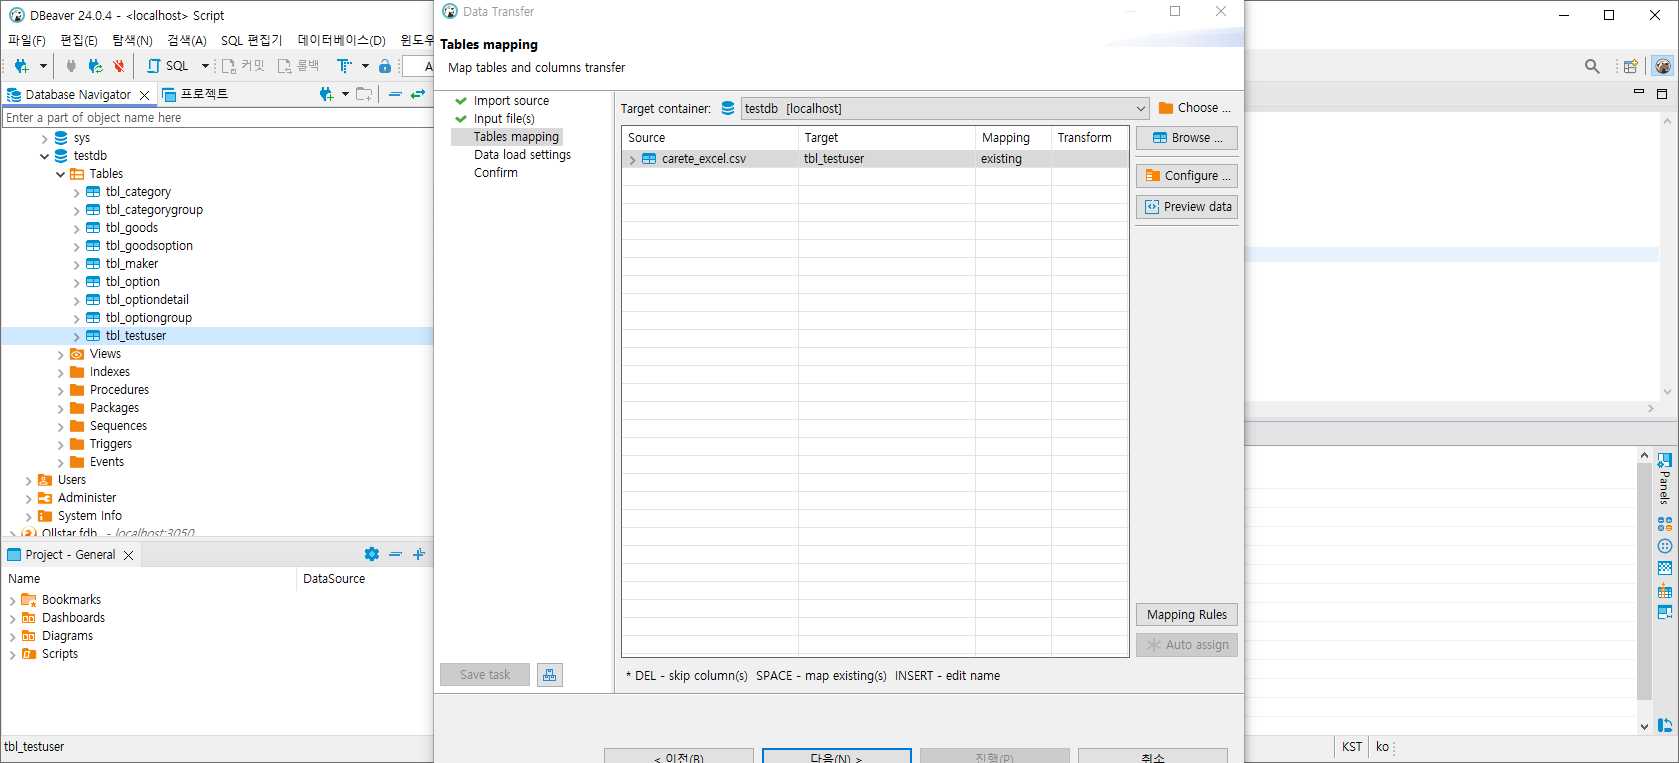
하단은 DBeaver를 이용해서 csv파일을 DB 테이블에 적용하는 방법입니다.
사용하시는 툴에 따라 적용하시면 되고 DBeraver를 사용하신다면 다음과 같이 CSV파일 데이터를 DB 테이블에 등록할때 하단과 같이 따라하시면 됩니다.


2.3.3. CSV 파일 DB 적용 소요시간.
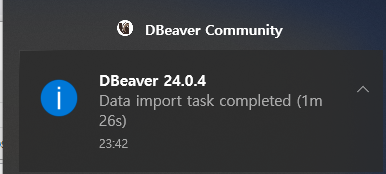
놀랍게도 csv파일을 DB에 직접 입력할 경우 1분 26초 밖에 걸리지 않는 것을 확인 할 수 있습니다.
3. 결론
1. python을 이용해 더미데이터를 생성하고 입력하는데 걸린 시간 15분
2. python을 이용해 csv파일을 생성하는데 걸린 시간 10분
생성된csv파일을 DB에 입력하는 시간 1분 26초
결과적으로 csv파일을 생성하여 DB에 입력하는데 4분가량 시간이 덜 소요된다는 것을 알 수 있습니다.
지금은 100만건 밖에 더미 데이터를 만들지 않았지만 휠씬 많은 1000만건이 넘는 데이터를 생성할 경우 시간은 휠씬 차이가 나게 됩니다.
다음은 1000만건 이상의 데이터를 생성하여 입력하는 것을 알아보겠습니다.
'기타 개발' 카테고리의 다른 글
| windows TortoiseSVN for addition, but is missing (0) | 2024.10.25 |
|---|---|
| windows hosts 파일 수정하기 (0) | 2024.07.31 |
| python 더미데이터 생성 후 DB JOIN 테이블 입력 (0) | 2024.07.29 |
| python Faker 라이브러리를 사용한 csv 더미 데이터 생성 (0) | 2024.07.29 |
| 1. 다나와는 카테고리와 옵션을 어떻게 구성했을까? (0) | 2024.07.28 |