1. 서론
python Faker를 이용해 csv 파일을 생성하는 것은 이전에 했지만 이번엔 csv파일을 생성하지 않고 DB를 연결하여 바로 더미데이터를 테이블에 입력해보도록 하겠습니다.
해당 방법은 데이터 양이 많지 않을 경우 10~20만건 정도는 직접 생성하여 등록해도 오래걸리지는 않지만 그 이상의 데이터 100만건 이상의 데이터를 입력할 경우는 등록에 시간이 오래걸리므로 대량 등록에는 csv파일을 사용하여 데이터를 만들고 등록하는 것이 좋습니다.
여기에서는 단일 테이블에 데이터를 입력하고 해당 테이블과 조인 관계에 있는 테이블에도 데이터를 등록해보도록 하겠습니다.
사용하는 툴은 vsCode, DBeaver, MariaDB 입니다.
python Faker 라이브러리를 사용하는 방법에 대해서는 설명하지 않으므로 다음의 이전 게시글을 참고하시기 바랍니다.
2024.07.29 - [기타 개발] - python Faker 라이브러리를 사용한 csv 더미 데이터 생성
python Faker 라이브러리를 사용한 csv 더미 데이터 생성
1. 서론더미 데이터를 만드는 방법이 여럿 있지만 간편하게 쓸 수 있는 python Faker 라이브러리를 사용해서 엑셀 데이터를 생성해보겠습니다.추후 직접 DB에 접속해서 등록하는 방법 csv파일로 추출
austar.tistory.com
2. 본문
2.1. DB 구조
2.1.1. ERD 논리 구조
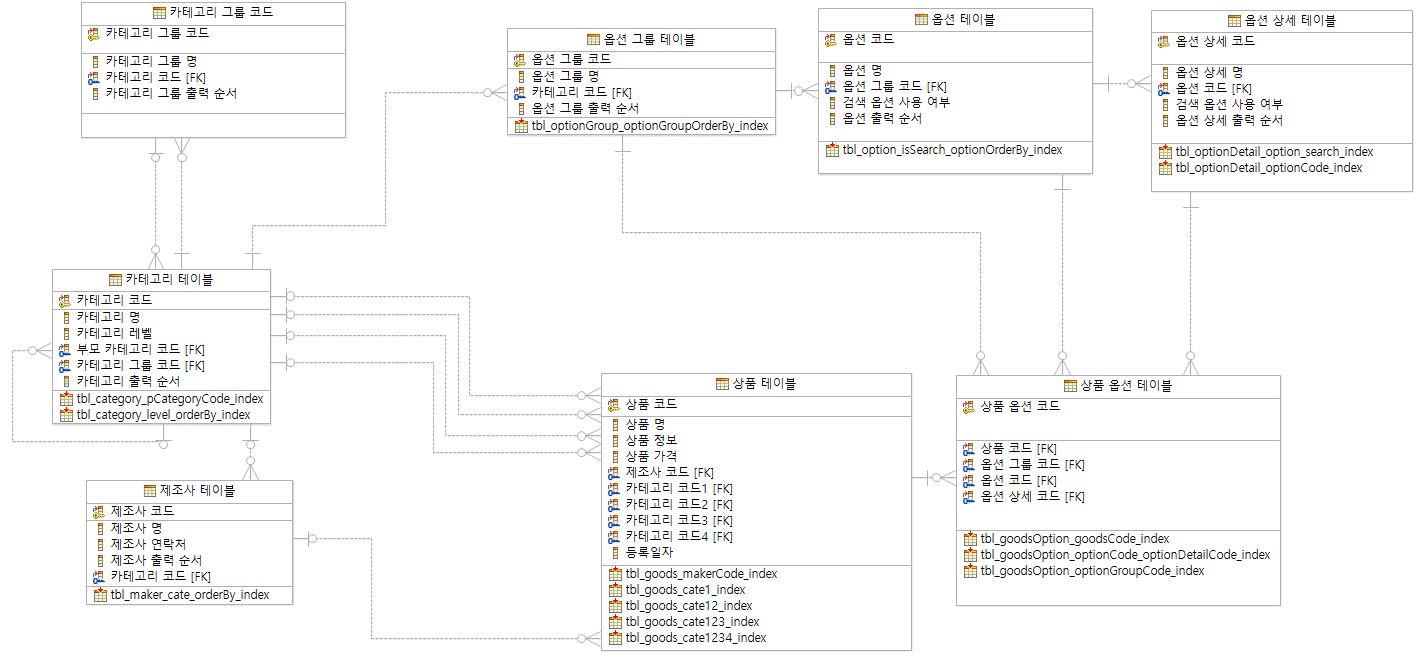
제가 사용할 테이블 구조는 이전에 만들었던 ERD 구조를 토대로 설명하도록 하겠습니다.
ERD에 대한 세세한 설명은 하지 않을 것이고 카테고리 테이블과 옵션 그룹 테이블에 데이터를 생성하여 등록해보도록 하겠습니다.
2.1.2. ERD 물리 구조
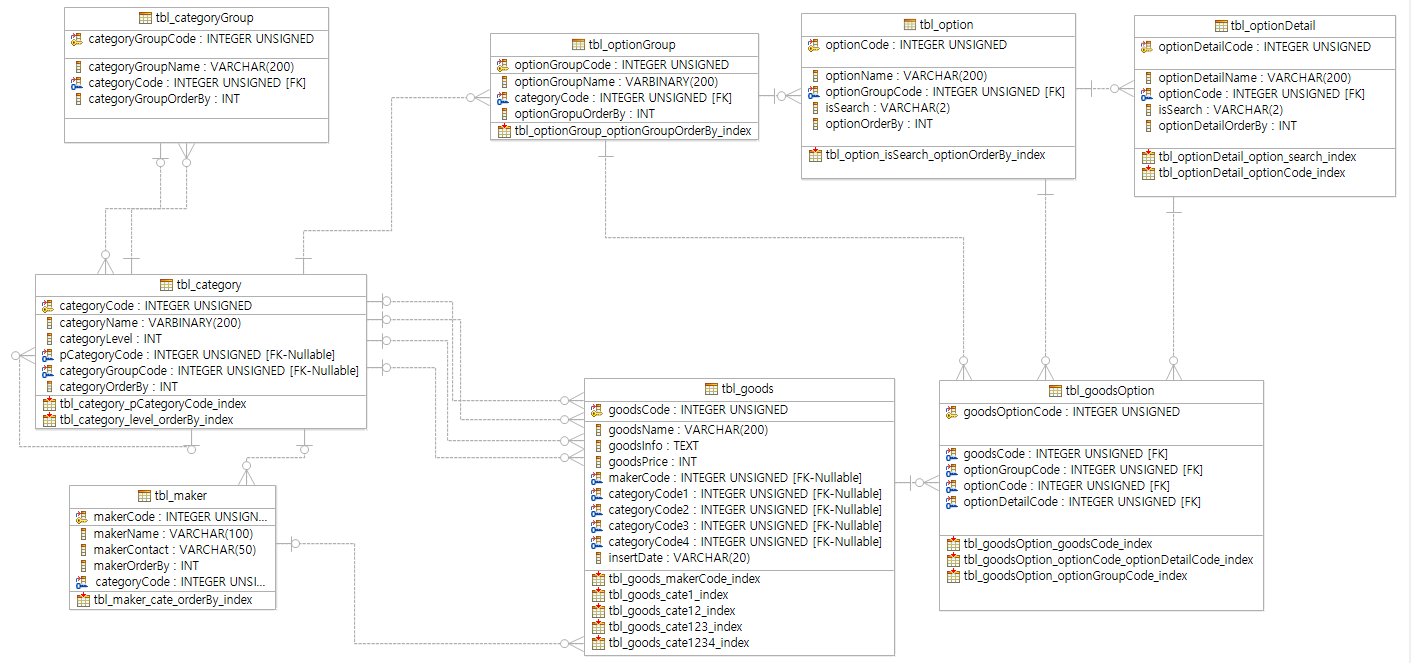
해당 테이블을 구조하는 물리 구조는 다음과 같습니다.
2.1.3. DDL
테스트를 위해 해당 테이블을 생성하는 DDL은 다음과 같습니다.
CREATE TABLE `tbl_category` (
	`categoryCode` INTEGER UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '카테고리 코드',
	`categoryName` VARBINARY(200) NOT NULL COMMENT '카테고리 명',
	`categoryLevel` INT DEFAULT 1 NOT NULL COMMENT '카테고리 레벨',
	`pCategoryCode` INTEGER UNSIGNED DEFAULT 0 COMMENT '부모 카테고리 코드',
	`categoryGroupCode` INTEGER UNSIGNED COMMENT '카테고리 그룹 코드',
	`categoryOrderBy` INT DEFAULT 0 NOT NULL COMMENT '카테고리 출력 순서',
	PRIMARY KEY (`categoryCode`)
) COMMENT='카테고리 테이블';

CREATE TABLE `tbl_optionGroup` (
	`optionGroupCode` INTEGER UNSIGNED NOT NULL AUTO_INCREMENT COMMENT '옵션 그룹 코드',
	`optionGroupName` VARBINARY(200) NOT NULL COMMENT '옵션 그룹 명',
	`categoryCode` INTEGER UNSIGNED NOT NULL COMMENT '카테고리 코드',
	`optionGropuOrderBy` INT DEFAULT 0 NOT NULL COMMENT '옵션 그룹 출력 순서',
	PRIMARY KEY (`optionGroupCode`)
);
해당 SQL을 실행 시킵니다.
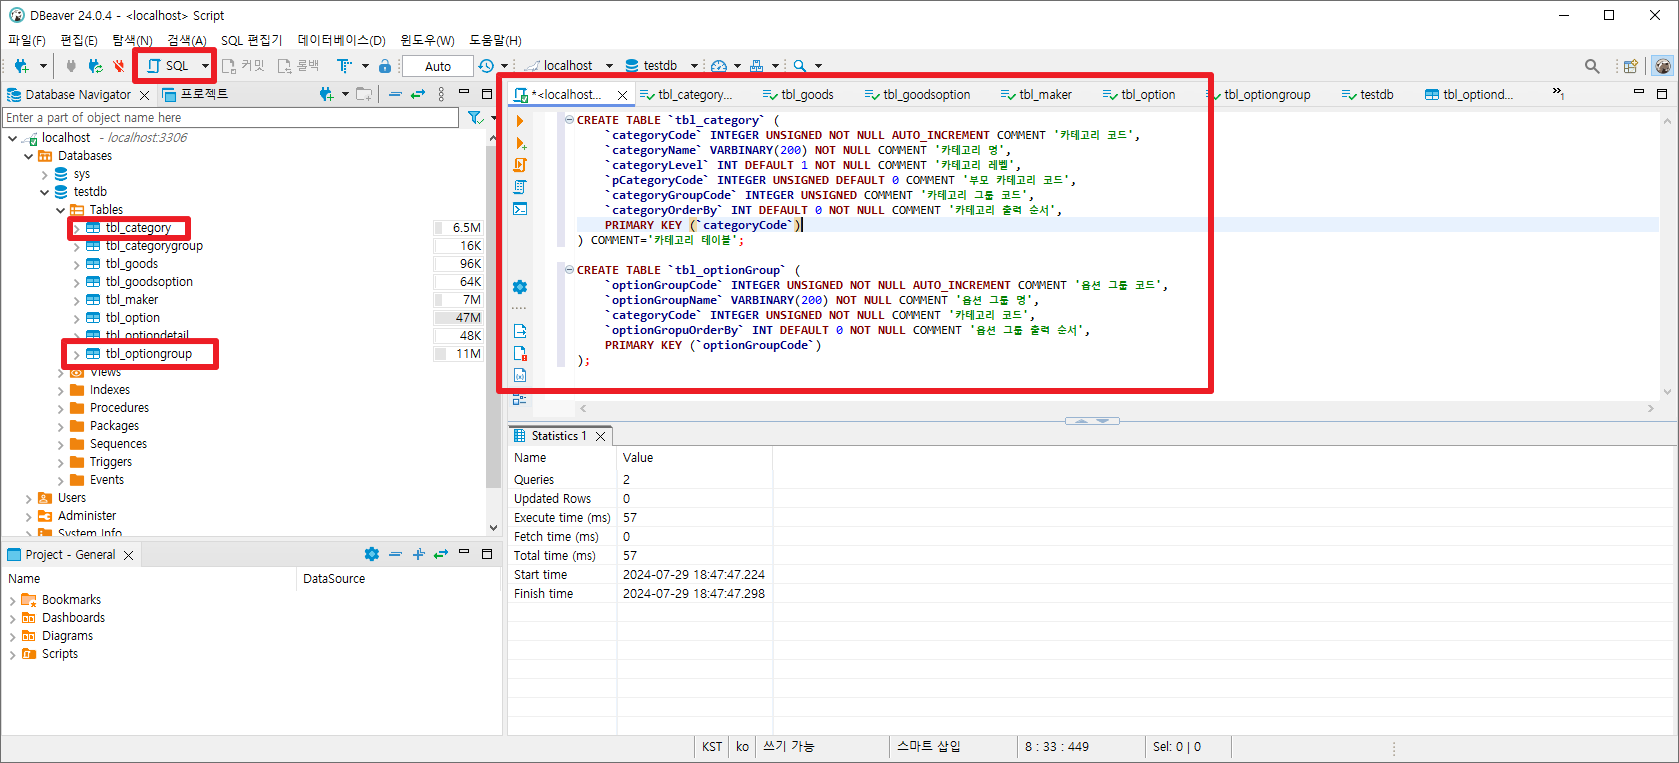
저는 DBeaver를 사용하기 때문에 좌측 상단에 SQL 빈 파일을 생성한 후 DDL을 입력하여 현재 사용하는 testdb에 해당 테이블을 생성했습니다.
2.2. 데이터 구조
실제 위에 ERD 테이블 구조에서는 카테고리 테이블은 4개의 레벨을 가진 카테고리로 구성되지만 여기서는 1개 레벨을 가지는 카테고리로 구성하고 해당 카테고리를 가지는 옵션 그룹 테이블에 데이터를 입력하도록 하겠습니다.
from faker import Faker
import mysql.connector

fake = Faker()

# MySQL 연결 설정
db = mysql.connector.connect(
    host="localhost",
    user="root",
    password="1234",
    database="testdb",
    charset="utf8mb4",
    collation="utf8mb4_general_ci"
)

cursor = db.cursor()

# tbl_category 테이블에 더미 데이터 삽입
order = 0
for _ in range(20):
    order = order + 1

    categoryName = fake.city()
    categoryLevel = 1
    pCategoryCode = 0
    categoryGroupCode = 0
    categoryOrderBy = order
    cursor.execute("INSERT INTO tbl_category (categoryName, categoryLevel, pCategoryCode, categoryGroupCode, categoryOrderBy) VALUES (%s, %s, %s, %s, %s)", (categoryName, categoryLevel, pCategoryCode, categoryGroupCode, categoryOrderBy))

db.commit()

cursor.close()
db.close()
위 소스는 python을 이용해 MySQL에 접속하고 특정 테이블에 20개의 더미 데이터를 입력하는 소스입니다.
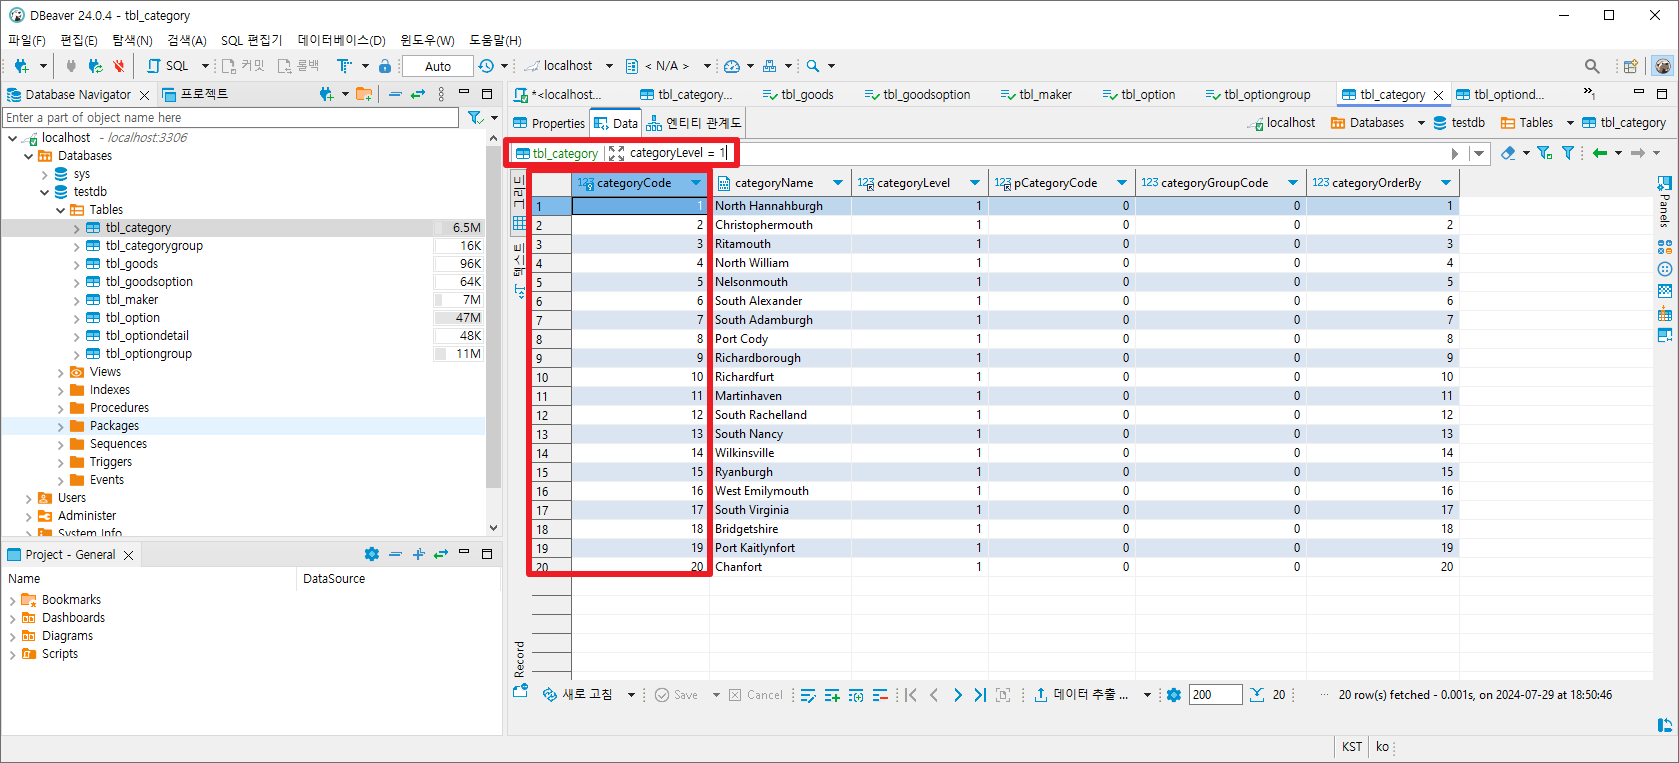
해당 소스를 실행하면 categoryLevel 값을 1로 가지는 더미 카테고리 데이터가 20개 생성됩니다.
2.3. JOIN 더미 데이터 생성
이제 해당 카테고리 테이블을 가지고 join되는 옵션 그룹 테이블에 더미 데이터를 생성하는 소스입니다.
from faker import Faker
import mysql.connector
import random

fake = Faker()

# MySQL 연결 설정
db = mysql.connector.connect(
    host="localhost",
    user="root",
    password="1234",
    database="testdb",
    charset="utf8mb4",
    collation="utf8mb4_general_ci"
)

cursor = db.cursor()

# 1차 카테고리 호출
cursor.execute("SELECT categoryCode FROM tbl_category WHERE categoryLevel = 1 ORDER BY categoryOrderBy")
arr_categoryCode = [row[0] for row in cursor.fetchall()]

# 1차 카테고리 반복
# tbl_optiongroup 테이블에 더미 데이터 삽입
for categoryCode in arr_categoryCode:
    num_orders = random.randint(20, 40)  # 20에서 40 사이의 랜덤한 숫자
    order = 0
    for _ in range(num_orders):
        order = order + 1

        optionGroupName = fake.word()
        optionGropuOrderBy = order

        cursor.execute("INSERT INTO tbl_optiongroup (optionGroupName, categoryCode, optionGropuOrderBy) VALUES (%s, %s, %s)", (optionGroupName, categoryCode, optionGropuOrderBy))

db.commit()

cursor.close()
db.close()
소스 내용을 보면 DB에 접속하여 1차 카테고리를 호출하고 해당 카테고리의 join 시킬 컬럼인 pk인 카테고리 코드를 호출하여 반복 문을 돌려 각 카테고리 코드별로 20~40개의 랜덤한 더미 데이터를 생성하여 주입합니다.
3. 결론
실제 테스트를 위해 더미 데이터를 만드는 것은 중요합니다.
10~20만건이 아닌 100만건이 넘는 최소 3~4천만건의 데이터를 입력하고 쿼리문에 대한 실행계획을 확인하고 테스트를 진행하는 것이 좋습니다.
현재 소개시켜드린 방법은 10~20만건의 데이터를 생성하는 것은 문제가 없지만 100만건이 넘어가는 건에 대해서는 실행 시간이 너무 오래걸리기에 csv파일을 생성하고 해당 파일을 DB에 직접 적용하는 것이 가장 좋습니다.
무엇보다 데이터는 대부분 join을 통해 관계성을 가지고있기 때문에 해당 join된 데이터를 만드는 방법을 사용하여 여러가지 상황에 응용하여 테스트를 해보시기 바랍니다.
다음으로는 관계성이 있는 데이터를 100만건 정도 csv파일로 생성하여 db에 등록하는 방법을 알아보도록 하겠습니다.
'기타 개발' 카테고리의 다른 글
| windows hosts 파일 수정하기 (0) | 2024.07.31 |
|---|---|
| 100만건 이상의 더미 데이터를 생성해보자. (0) | 2024.07.30 |
| python Faker 라이브러리를 사용한 csv 더미 데이터 생성 (0) | 2024.07.29 |
| 1. 다나와는 카테고리와 옵션을 어떻게 구성했을까? (0) | 2024.07.28 |
| Dockerfile 이미지 생성 및 실행 (0) | 2024.06.19 |